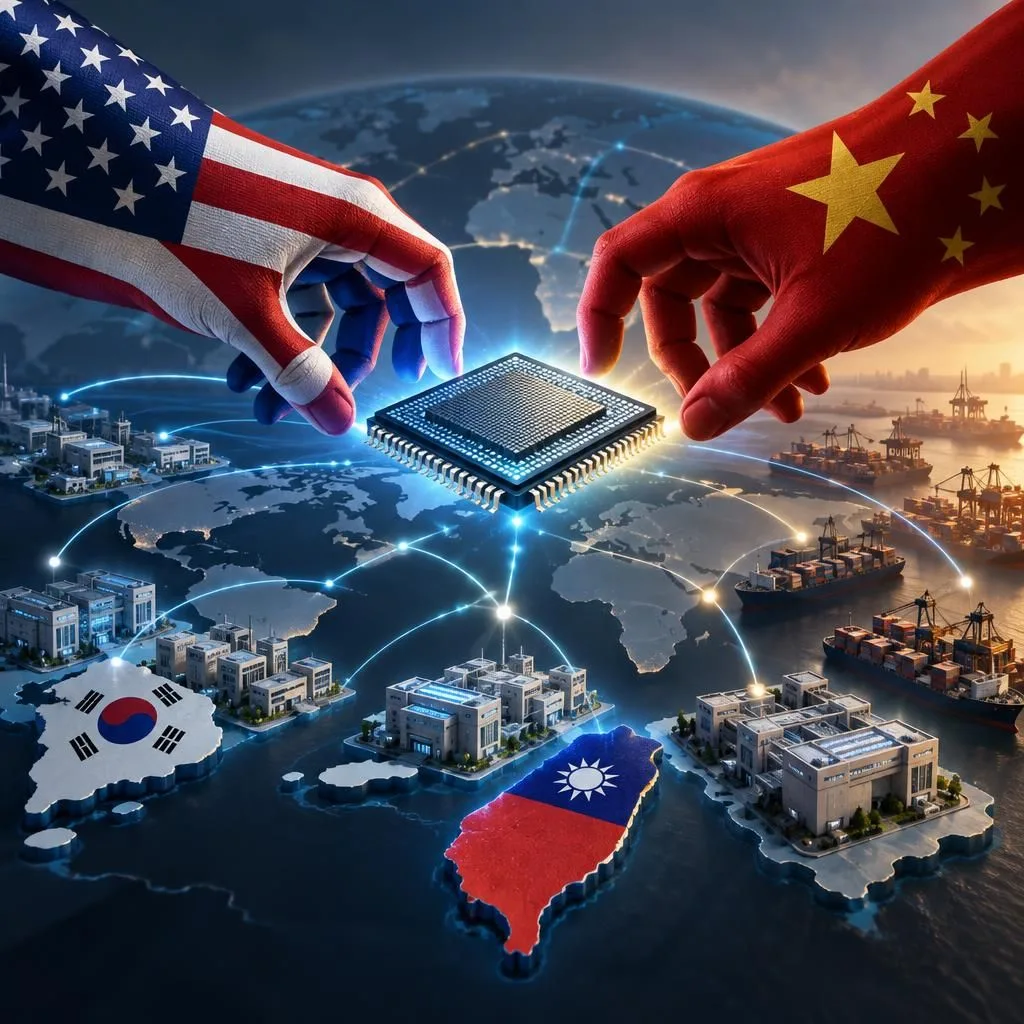
미중 반도체 패권 경쟁과 글로벌 공급망의 미래
미국과 중국의 반도체 기술 패권 다툼이 심화되면서 글로벌 공급망이 근본적인 재편을 겪고 있습니다. 양국의 전략과 함께 한국과 대만 등 주요 반도체 제조 거점들이 직면한 도전 과제를 살펴봅니다.
2026. 09. 21.
구글의 TPU는 강력한 가격 대비 성능과 전력 효율성을 제공하지만, 엔비디아를 대체하기 위해서는 CUDA의 방대한 소프트웨어 생태계, 개발자 인지도, 그리고 멀티 클라우드 유연성이라는 장벽을 극복해야 합니다.
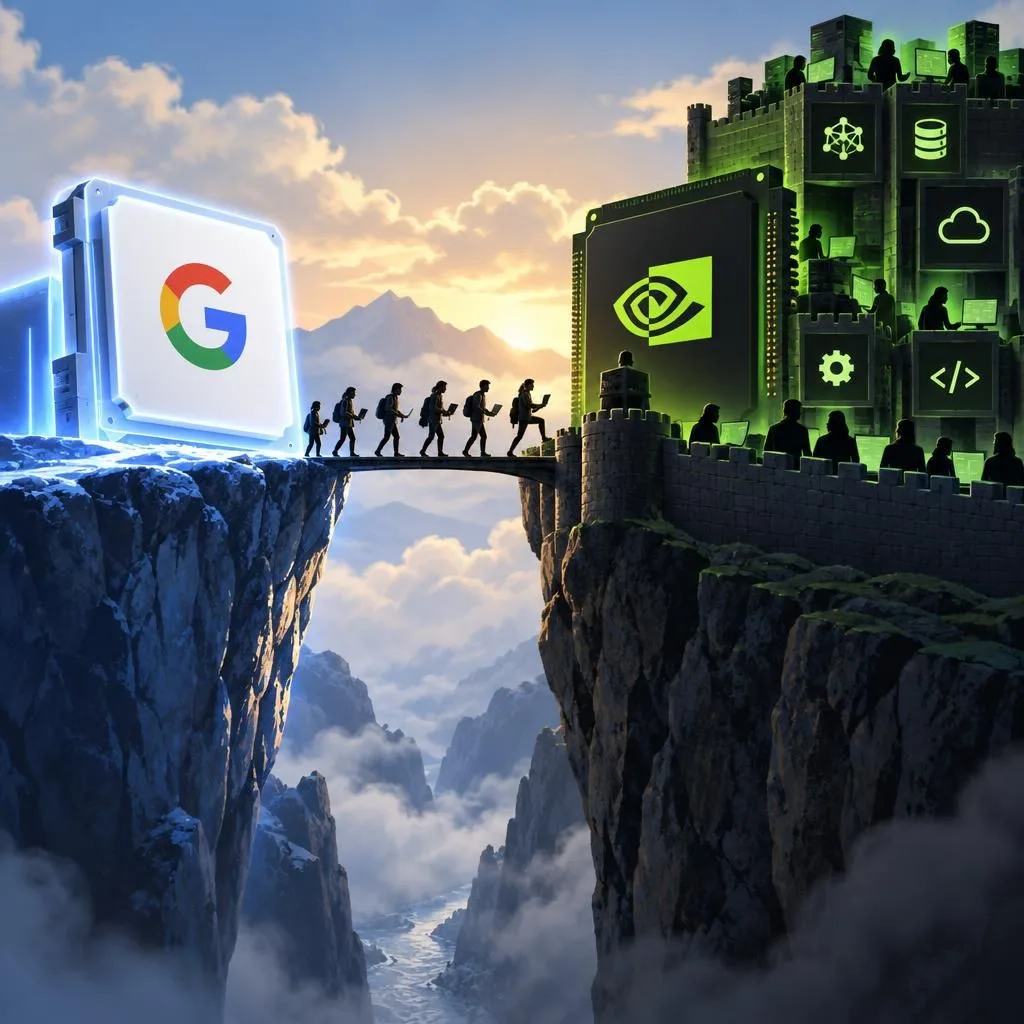
인공지능 모델의 규모와 복잡성이 지속적으로 확대됨에 따라 컴퓨팅 하드웨어를 둘러싼 논쟁도 한층 치열해지고 있습니다. 이 경쟁의 중심에는 구글의 텐서 처리 장치(TPU)와 엔비디아의 독보적인 그래픽 처리 장치(GPU)가 자리 잡고 있습니다. 그러나 진정한 승부는 단순히 순수 실리콘 하드웨어 스펙만으로 결정되지 않습니다. 핵심 질문은 구글의 하드웨어와 이를 지원하는 소프트웨어 스택이 엔비디아의 독점 컴퓨팅 플랫폼인 CUDA가 구축한 거대한 경쟁 우위의 해자를 넘어설 수 있느냐는 점입니다.
구글이 승리할 수 있을지 평가하려면, TPU와 CUDA를 직접 비교하는 것이 주문형 반도체(ASIC)와 소프트웨어 개발 플랫폼을 비교하는 것임을 먼저 이해해야 합니다. 엔비디아의 CUDA(Compute Unified Device Architecture)는 거의 20년에 걸쳐 GPU 가속 컴퓨팅의 사실상 표준으로 발전해 왔습니다. 수백만 명의 엔지니어가 매일 의존하는 로우레벨 프리미티브 라이브러리, 프로파일링 도구, 직접적인 커널 최적화를 지원합니다.
반면, 구글의 TPU는 주로 (수스톨릭 어레이 아키텍처를 활용한) 행렬 곱셈 연산에 중점을 두고 설계된 도메인 특화 가속기입니다. TPU의 소프트웨어 인터페이스는 CUDA처럼 직접적이고 명령형인 커널 해킹 방식을 제공하기보다는 XLA(Accelerated Linear Algebra)와 같은 중간 컴파일러 및 JAX, 텐서플로(TensorFlow) 같은 상위 레벨 프레임워크에 크게 의존합니다.
엔비디아의 소프트웨어 지배력은 강력한 네트워크 효과와 깊은 기업 전환 비용(switching costs)에 의해 유지됩니다:
개발자 인지도 및 교육: 15년 이상 컴퓨터 과학 커리큘럼, 박사 과정 연구 및 오픈소스 AI 프로젝트는 기본적으로 CUDA를 기반으로 구축되었습니다. 발표된 대부분의 최첨단 AI 연구는 엔비디아 환경을 전제로 한 코드 저장소를 제공합니다.
파이토치(PyTorch) 생태계: 파이토치는 연구자와 기업 실무자 사이에서 지배적인 딥러닝 프레임워크로 자리 잡았습니다. PyTorch/XLA를 통해 TPU를 타깃으로 삼을 수는 있지만, 네이티브 성능, 디버깅 편의성, 커스텀 연산자 확장은 압도적으로 엔비디아 GPU에 맞춰 정교하게 다듬어져 있습니다.
클라우드 전반의 벤더 중립성: 엔비디아 GPU는 아마존 웹 서비스(AWS), 마이크로소프트 애저(Azure), 구글 클라우드, 오라클 클라우드, 온프레미스 데이터 센터 등 어디에나 배포할 수 있습니다. 반면 TPU는 대부분 구글 클라우드 플랫폼에 종속되어 있어, 단일 제공업체 의존도를 경계하는 기업들에게 전략적 락인(lock-in) 우려를 불러일으킵니다.
CUDA의 확고한 입지에도 불구하고, 구글의 TPU 프로젝트는 순수한 기술 역량 측면에서 결코 뒤처지지 않습니다. 구글 내부 프로덕션 환경에서 TPU는 검색, 유튜브 추천 시스템, 제미나이(Gemini)와 같은 최첨단 모델을 포함한 대규모 워크로드를 구동하고 있습니다.
TPU가 경쟁력을 발휘할 수 있게 하는 핵심 요인은 다음과 같습니다:
공동 설계된 인터커넥트(광학 회로 스위치): TPU 클러스터(Pod)는 뛰어난 스케일링 효율성을 제공하는 맞춤형 네트워킹 아키텍처의 이점을 누려, 대규모 슈퍼컴퓨팅 클러스터가 네트워킹 병목 현상을 최소화하면서 파운데이션 모델을 훈련할 수 있도록 지원합니다.
비용 및 에너지 효율성: TPU는 텐서 연산에 특화되어 설계되었고 레거시 그래픽 파이프라인이 없기 때문에, 범용 GPU에 비해 부동 소수점 연산당 가격 대비 성능과 에너지 효율성이 우수한 경우가 많습니다.
OpenXLA와 JAX의 부상: JAX는 고성능 수치 계산을 위해 머신러닝 연구자들 사이에서 폭발적인 인기를 얻고 있습니다. 하드웨어에 구애받지 않는 컴파일을 목표로 하는 오픈소스 컨소시엄인 OpenXLA와 함께, 업계는 독점적인 CUDA 커널로부터 모델 아키텍처를 분리하기 위해 적극적으로 움직이고 있습니다.
구글의 TPU가 엔터프라이즈 컴퓨팅 환경에서 CUDA를 "패배"시킬 수 있을까요? 단기에서 중기적으로 볼 때, 광범위한 기업 시장 전반에서 완전한 대체가 일어날 가능성은 희박합니다. CUDA의 유비쿼터스한 보급률, 툴체인의 성숙도, 모든 주요 클라우드에서의 하드웨어 가용성은 엔비디아에 지속적인 경쟁 보호막을 제공합니다.
TPU와 CUDA 간의 경쟁은 제로섬 하드웨어 충돌이 아닙니다. 이는 특화된 클라우드 네이티브 규모와 보편적인 개발자 이동성 사이의 경제적 줄다리기입니다.
구글의 TPU 전략은 CUDA를 완전히 제거하기보다는, 다른 측면에서 매우 성공적인 목표를 달성하고 있습니다. 알파벳(Alphabet)을 엔비디아의 가격 결정력으로부터 보호하고, 내부 컴퓨팅 주권을 보장하며, 비용을 중시하는 클라우드 고객에게 대규모 학습을 위한 신뢰할 수 있는 대안을 제공하는 것입니다. Triton과 OpenXLA 같은 컴파일러 계층이 성숙해짐에 따라 CUDA와 커스텀 ASIC 간 이동의 마찰은 줄어들 것이며, 이는 완전히 깨뜨리지는 못하더라도 엔비디아의 전설적인 소프트웨어 지배력을 점진적으로 완화시킬 것입니다.
미국과 중국의 반도체 기술 패권 다툼이 심화되면서 글로벌 공급망이 근본적인 재편을 겪고 있습니다. 양국의 전략과 함께 한국과 대만 등 주요 반도체 제조 거점들이 직면한 도전 과제를 살펴봅니다.
파리지앵 스타일의 중정, 푸른 녹음, 시그니처 브런치 메뉴와 유용한 방문 팁까지, 강남 도산대로와 도산공원 일대의 대표적인 야외 테라스 카페를 만나보세요.
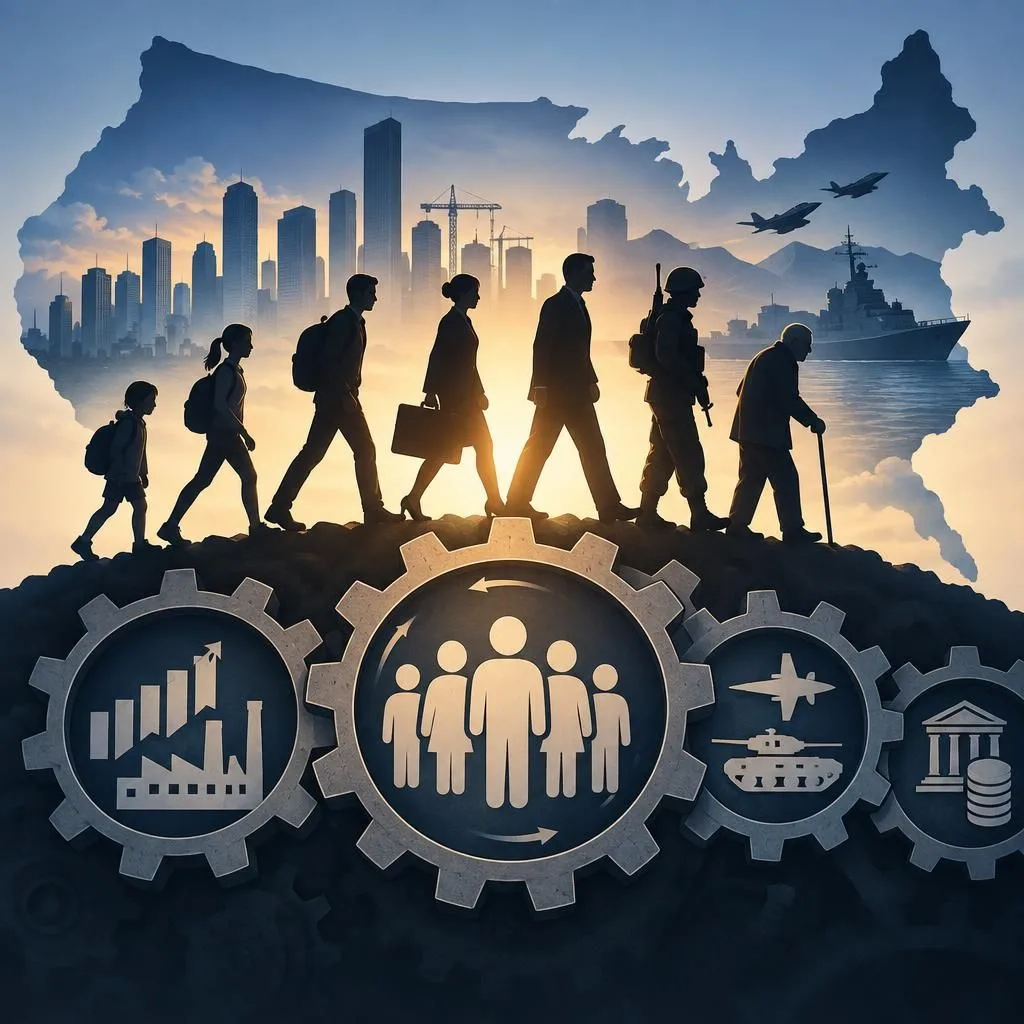
인구 통계적 추세는 단순한 인구수 이상의 것을 결정합니다. 노동력 공급과 재정 건전성부터 군 징집에 이르기까지, 국가의 연령 구조는 지정학적 영향력의 한계를 규정합니다.